 Okdalto
강화학습으로 수박 게임 클리어하기
추억의 수박 게임을 기억하시는지? 침착맨이 이 게임을 플레이하는 걸 보다가, 강화학습으로 학습시켜 보면 재미있겠다는 생각이 들었다. 마침 추석 연휴이기도 해서, 강화학습 공부도 할 겸 클로드와 함께 직접 구현해보기로 했다.
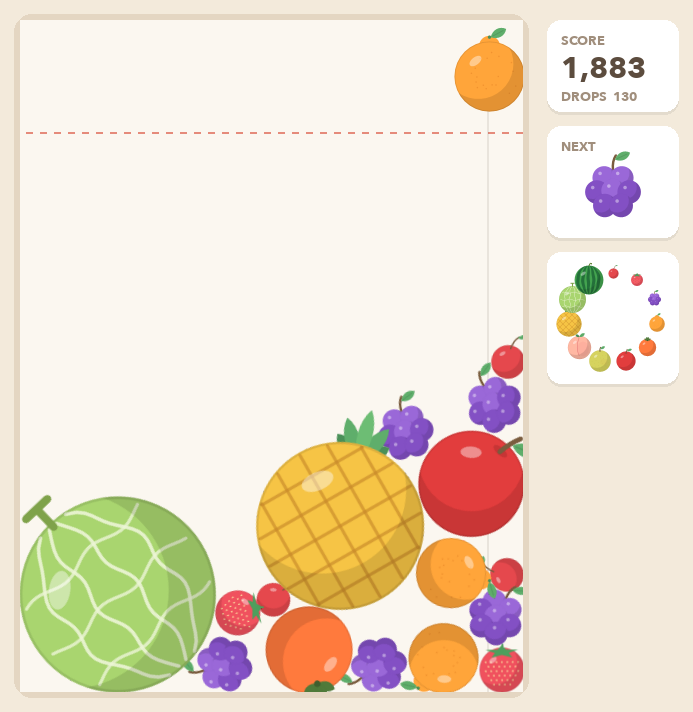
강화학습을 하려면 먼저 환경이 필요하다. 그래서 환경 역할을 할 게임부터 만들었다. 물리 엔진은 Pymunk, 화면 렌더링은 Pygame을 사용했다.
규칙은 단순하다. 에이전트는 과일을 떨어뜨릴 위치를 32칸 중 하나로 고른다. 과일이 멈출 때까지 기다린 뒤 다음 과일을 놓는다. 같은 과일끼리 닿으면 한 단계 큰 과일로 합쳐지고, 과일이 기준선을 넘으면 게임이 끝난다. 에이전트가 배우는 건 결국 32칸 중 어디에 과일을 떨어뜨리는가이다.
첫 번째로 사용한 알고리즘은 PPO였다. PPO는 Proximal Policy Optimization의 약자로, 강화학습에서 널리 사용되는 policy gradient 계열 알고리즘이다. Policy gradient는 기대 보상이 커지는 방향으로 policy의 파라미터를 직접 업데이트하는 방법이다.
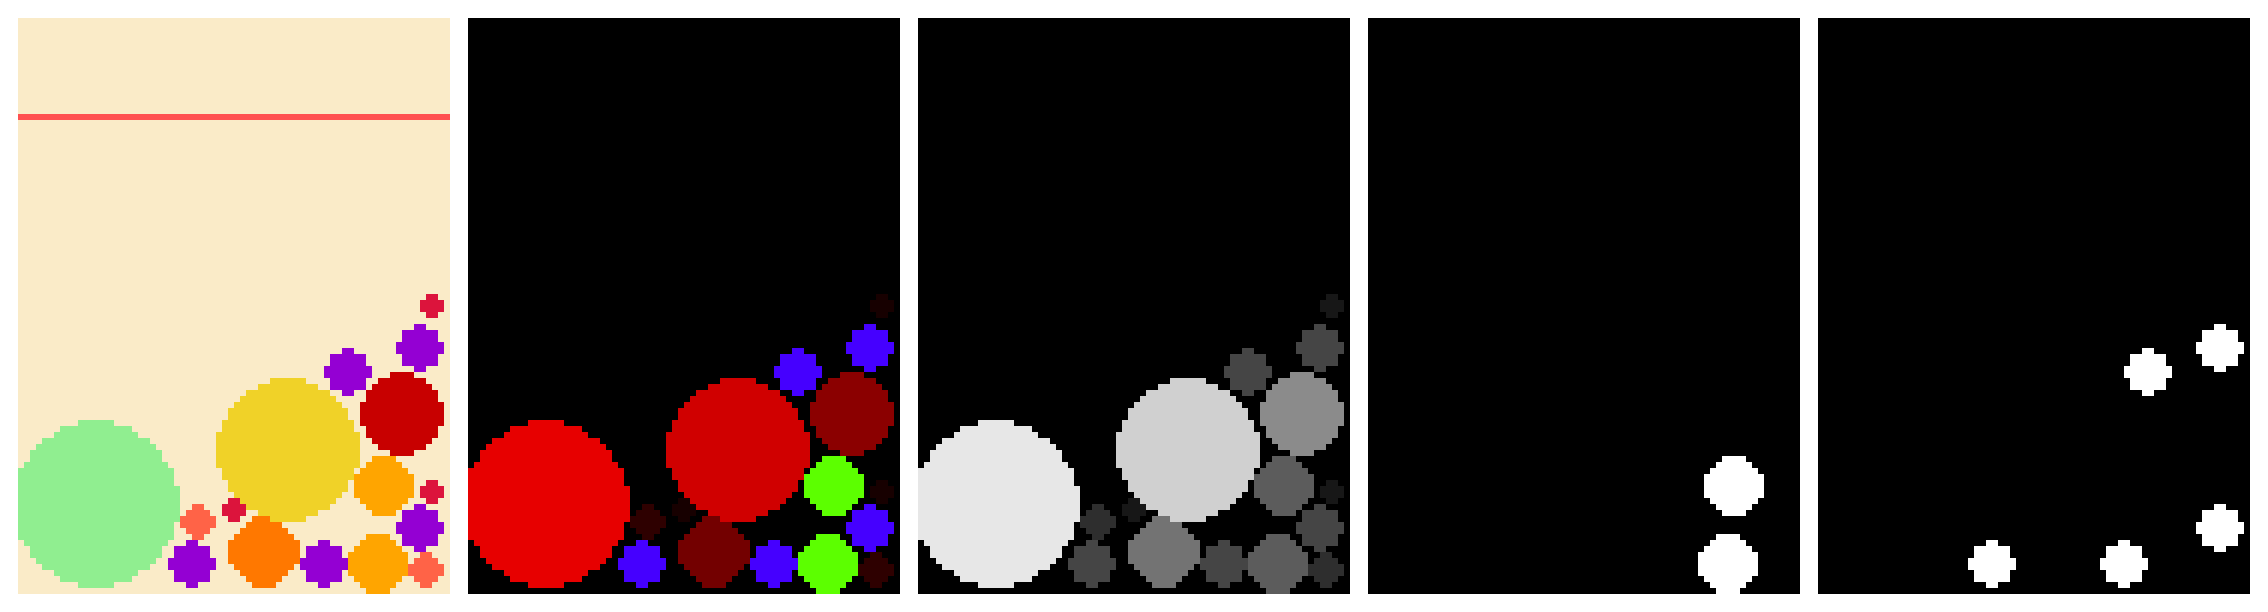
게임 화면을 축소해서 convolution 기반 policy network의 인풋으로 주고, 과일이 합쳐질 때마다 reward를 주었다. 랜덤하게 과일을 놓으면 약 1,500점 정도가 나왔는데, 학습한 에이전트도 비슷한 1,500점 근처에 머물렀다. 실패다.
하이퍼파라미터를 바꾸고, 관측값을 바꾸고, policy network 구조도 바꿔봤다. 하지만 결과는 크게 달라지지 않았다. 오히려 매번 가운데에 과일을 떨어뜨리는 단순한 전략이 꽤 잘 버텼다.
그래서 접근을 바꿨다. 매 턴마다 32개 위치에 과일을 각각 떨어뜨려 보고, 그중 즉시 얻는 점수가 가장 높은 위치를 선택하는 일종의 1-step greedy 전략을 만들었다. 이 방식은 4,400점까지 올라갔다.
다음에는 이 전략이 생성한 약 4만 수의 데이터를 신경망이 그대로 따라 하도록 학습시켰다. Behavioral Cloning(BC)이다. 강화학습 없이도 평균 3,390점 정도가 나왔다.
여기서 한 가지 문제가 보였다. 한 판을 플레이하다 보면 32개 위치 중 절반가량은 어디에 놓아도 결과가 거의 비슷하다. 정말 중요한 수는 가끔 등장하는데, 그 신호는 연쇄 합체에서 얻는 큰 점수에 쉽게 묻힌다. 즉, 모든 수가 같은 정도로 중요한 것이 아니었다.
BC 위에 PPO를 다시 올려봤지만 별다른 효과는 없었다. 그래서 reward를 다시 설계했다. 과일이 기준선을 넘으면 300점을 감점하고, 과일 더미의 높이가 낮아질수록 약간의 추가 reward를 주었다.
그러자 BC보다 평균 점수가 538점 올라갔다. 플레이를 비교해보니, 과일을 더 잘 합치는 법을 배운 것이 아니라 더 오래 버티는 법을 배운 것이었다. 과일이 기준선 근처까지 쌓여도 적절한 합체를 통해 높이를 낮추면서 위기에서 빠져나왔다. 한 수 앞의 즉시 점수만 보고 행동하는 greedy 전략을 따라 한 BC에서는 배우기 어려운 행동이었다.
가장 큰 이득은 학습 밖에서 나왔다. 학습된 policy network에는 지금 상태가 얼마나 좋은지를 예측하는 value function이 함께 붙어 있다. 이 value function을 들고, 매 턴 32개 위치에 실제로 과일을 떨어뜨려 본 뒤 즉시 점수와 예측한 미래 가치를 더해 가장 좋은 곳을 골랐다. 미래 가치를 그대로 더하면 오히려 점수가 떨어졌다. 후보 32개가 서로 너무 비슷해서, 가장 좋아 보이는 수는 대개 예측 오차가 가장 크게 튄 수였다. 미래 가치에 0.05의 가중치만 주자 평균 4,953점이 나왔다. policy가 혼자 둘 때보다 1,000점 가까이 높았다.
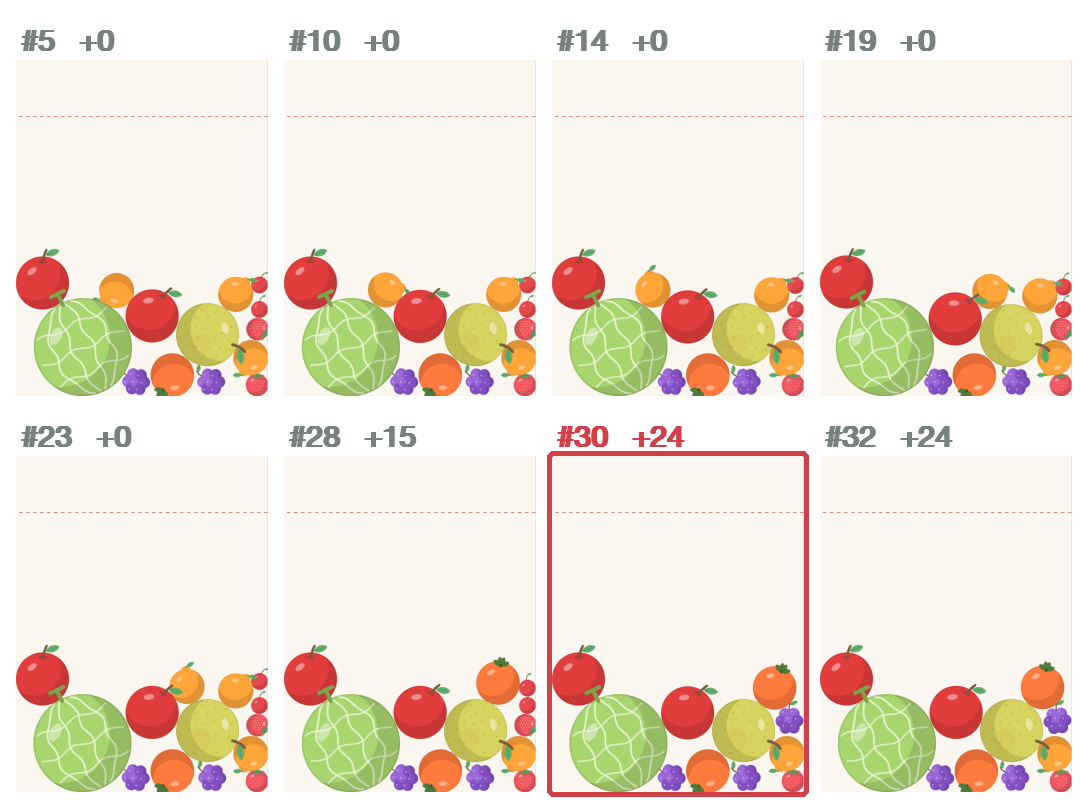
그렇다면 탐색이 둔 수를 policy에게 가르치면 되지 않을까. 탐색 에이전트가 55만 수를 두게 하고, policy가 그걸 따라하도록 학습시켰다. 화면 해상도를 두 배로 올려보고, 과일 종류를 채널별로 나눠보고, 아예 화면 대신 과일 하나하나의 정확한 좌표를 Transformer에 넣어보기도 했다. 전부 4,000점 근처에서 멈췄다. 탐색이 고른 수를 맞힌 비율은 15%를 넘지 못했다. policy는 과일이 어디로 굴러가 무엇과 부딪힐지를 끝내 배우지 못했다.
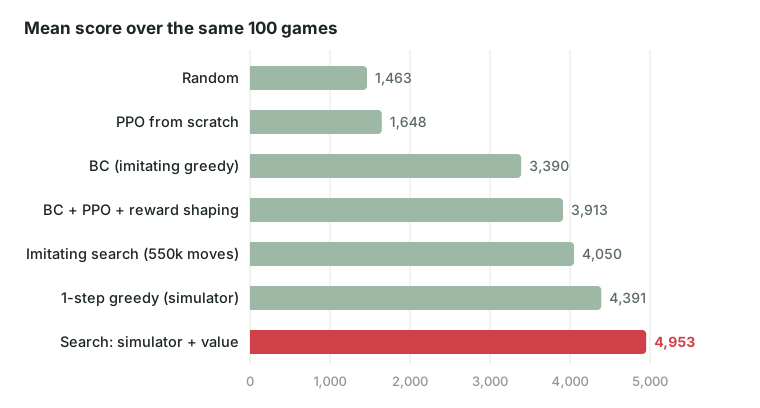
이유는 물리에 있다. 과일이 몇 픽셀 차이로 닿느냐 비껴가느냐, 그 뒤에 연쇄 합체가 일어나느냐는 초기 조건에 민감하다. 한 장면만 보고 한 번에 맞히기는 아주 어려운 문제다. 탐색 정책은 그걸 맞히려 하지 않는다. 매번 직접 굴려서 확인하고, 점수를 극대화한다. 결국 차이를 만든 건 모델의 구조가 아니라, 판단하기 전에 시뮬레이터에 물어볼 수 있느냐였다.
이 놀이에서 배운 것은 두 가지다. 에이전트에게 어떤 reward를 주느냐에 따라 배우는 전략이 완전히 달라진다는 것. 그리고 세상의 모델을 가지고 있다면, 그걸 머릿속에 쑤셔넣는 것보다 필요할 때 꺼내 쓰는 쪽이 낫다는 것. 어찌 보면 둘 다 당연한 소리일지도.
아무튼 재미있었다. 여러분도 심심할 때 강화학습을 구현해보시라.
Comments